
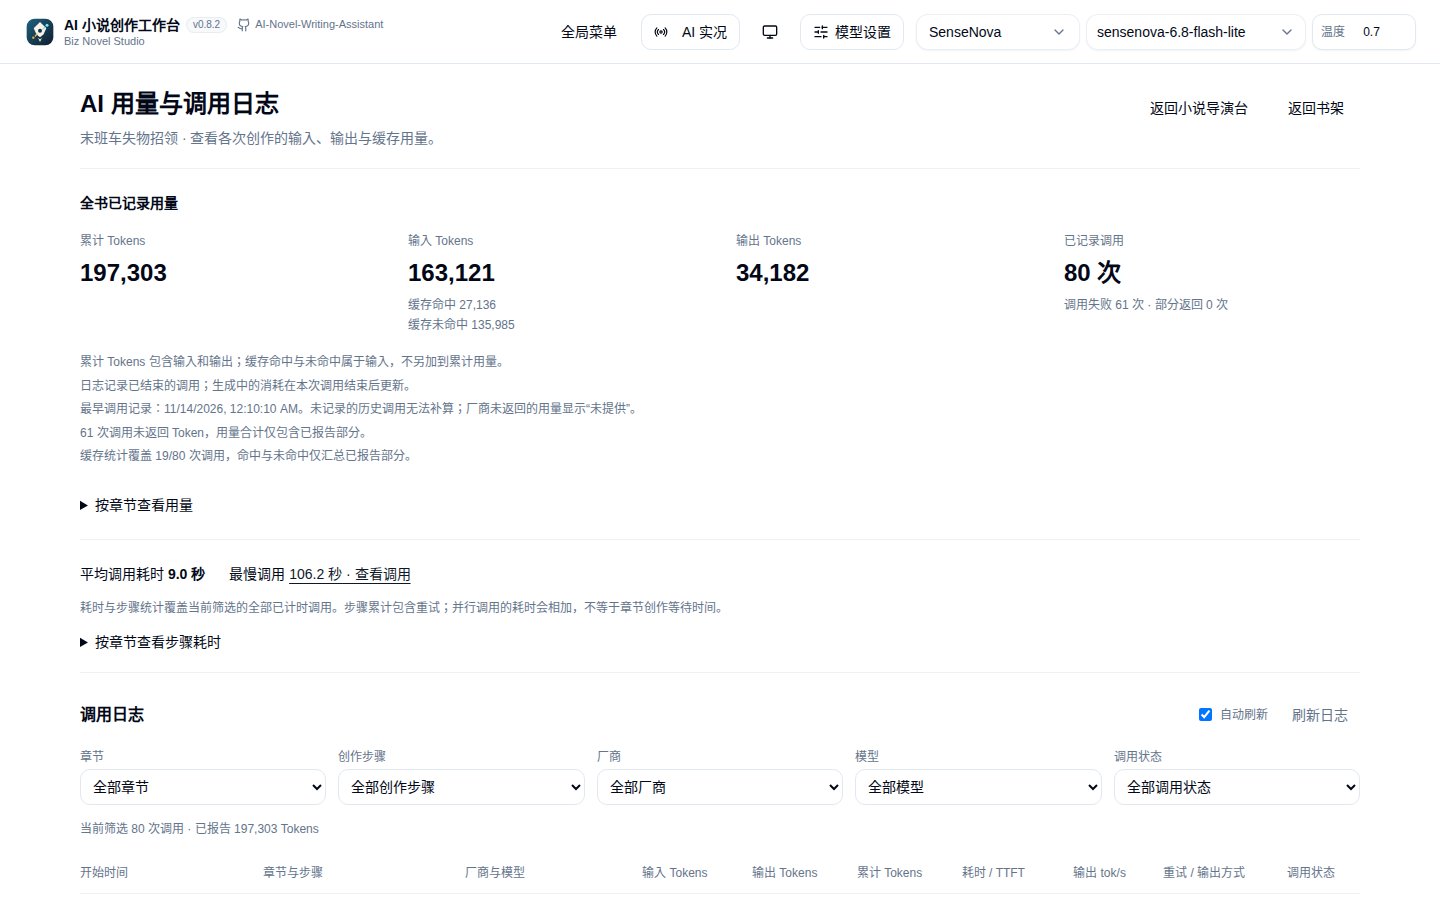
AI 用量与调用日志,展示全书累计用量、缓存命中与调用日志列表
用量页覆盖已记录的调用;未记录的旧历史不会被估算补齐。实际费用以厂商账单为准。
AI 用量怎么看
在 V2 本书顶部或书架打开 「AI 用量」,可以查看和筛选调用记录。查看维度
理解总 Tokens
总 Tokens = 输入 Tokens + 输出 Tokens。 缓存命中与未命中都属于输入,不要再加一次。 规划、正文、审阅和修文都可能产生消耗,不能只按最终正文长度判断费用。查看单次调用详情
在调用日志里展开一次调用,除了耗时和尝试链,还可以看到:- 输出预算:这次调用实际允许输出的 Tokens 和额度来源,例如自动预算、模型路由或模型输出上限。展开后可以看到各项候选值,以及给思考留出的预留。
- 模型结束原因:模型返回的结束原因,可用来判断输出是正常结束还是因额度用完被截断。
- 结构校验:结构化结果是否通过校验。
Token 缓存与调用优化
长篇创作会反复使用本书约定、写法与世界规则。工作台把可复用的规则和书级、卷级资料放在输入前部,再附上本章任务、当前状态与正文,为模型供应商复用相同前缀提供条件。哪些部分做了优化
- 稳定资料前置:表达规则、作品约定和适用的世界规则按复用范围组织;每次读取当前资料,修改设置后后续调用使用新内容。
- 同章修文复用前缀:局部修文把本次修复重点放在同章资料和正文之后,资料与正文未变化时更容易复用前缀。
- 有效审校结果复用:正文、创作约定、检查规则、模型与参数等相关条件一致时,复用有效的检查结果,减少重复调用。
- 减少无效修文与复验:检查区分必须修复的缺口和普通表达建议,残余局部问题保留为质量提醒,避免反复改整章。
不同步骤的复用空间
正文需要输入新的剧情和状态,这部分未命中是正常成本。首次调用、切换模型或通道、修改书级资料,也可能让命中量发生变化。
查看实际效果
在本书「AI 用量」中筛选同一章节、步骤与模型,比较连续调用的输入、输出、命中和未命中 Tokens。也可以在 AI 实况 中查看正在执行的调用。 缓存统计以厂商实际返回为准;未提供的字段显示「未知」。实际费用以厂商账单为准。单章用量保护
V2 新任务的单章默认用量保护上限为 200,000 Tokens,累计包含该章的生成、检查、修文与资料整理调用。更早开始的任务保留原来的 100,000 Tokens。计算方式
- 新章节:按输入扣除供应商已报告的缓存命中后,加输出计数。
- 历史章节:保留原计量方式。
自动追加一次
开始任务时没有填写单章额度,且没有在 设置 → 自动导演 保存过全局额度时,任务使用系统默认额度。这时每章额度不足,会先自动追加一次,把本章额度调到建议值,然后继续执行,不需要你确认。导演台的「第 N 章用量与额度」会显示「本章已自动追加 X Tokens」。 建议值超过当前额度的两倍,或本章已经自动追加过时,不会再自动追加。开始任务时填写了额度,或使用已保存的全局设置时,每次追加都需要你确认。达到上限后
达到上限时,系统会在本书导演台暂停并展示原因和建议额度,你可以按建议额度或自定额度继续本章;正文、累计用量和恢复位置都会保留。触发上限后的处理流程
用量筛选路径
你可以从以下维度穿透查看调用记录:用量计算器
下面的计算器帮助你理解单章用量的构成与保护上限的关系。输入各参数后,它会按规则计算计费 Tokens 和占默认上限的比例。此计算器为示意工具,用于理解用量构成规则。实际用量与费用以工作台 AI 用量页记录和厂商账单为准。
常见问题
缓存命中为什么能减少成本
缓存命中为什么能减少成本
厂商对缓存命中部分通常收取较低单价。缓存复用的是已处理过的输入前缀,因此新调用只需为新增内容和输出付费。
命中率低怎么办
命中率低怎么办
先看是否频繁切换模型或修改书级资料,再看章节任务是否变化过大。稳定资料前置和固定写法规则有助于提升命中。
单章上限可以调整吗
单章上限可以调整吗
可以。开始任务时可以为本任务填写单章额度,也可以到 设置 → 自动导演 修改新任务的全局默认值。达到上限时可在本书导演台按建议或自定额度继续,系统会保留已有正文和累计用量。
为什么实际费用和用量页不同
为什么实际费用和用量页不同
Tokens 是调用计数,不同厂商对输入、输出和缓存的定价不同。实际费用以厂商账单为准。
用量页显示「未知」是什么意思
用量页显示「未知」是什么意思
缓存统计依赖厂商返回。若厂商未提供命中/未命中数据,则显示「未知」,不应当作零。
自动导演
了解长篇推进中各阶段的调用来源
模型配置
配置供应商、模型路由与输出上限